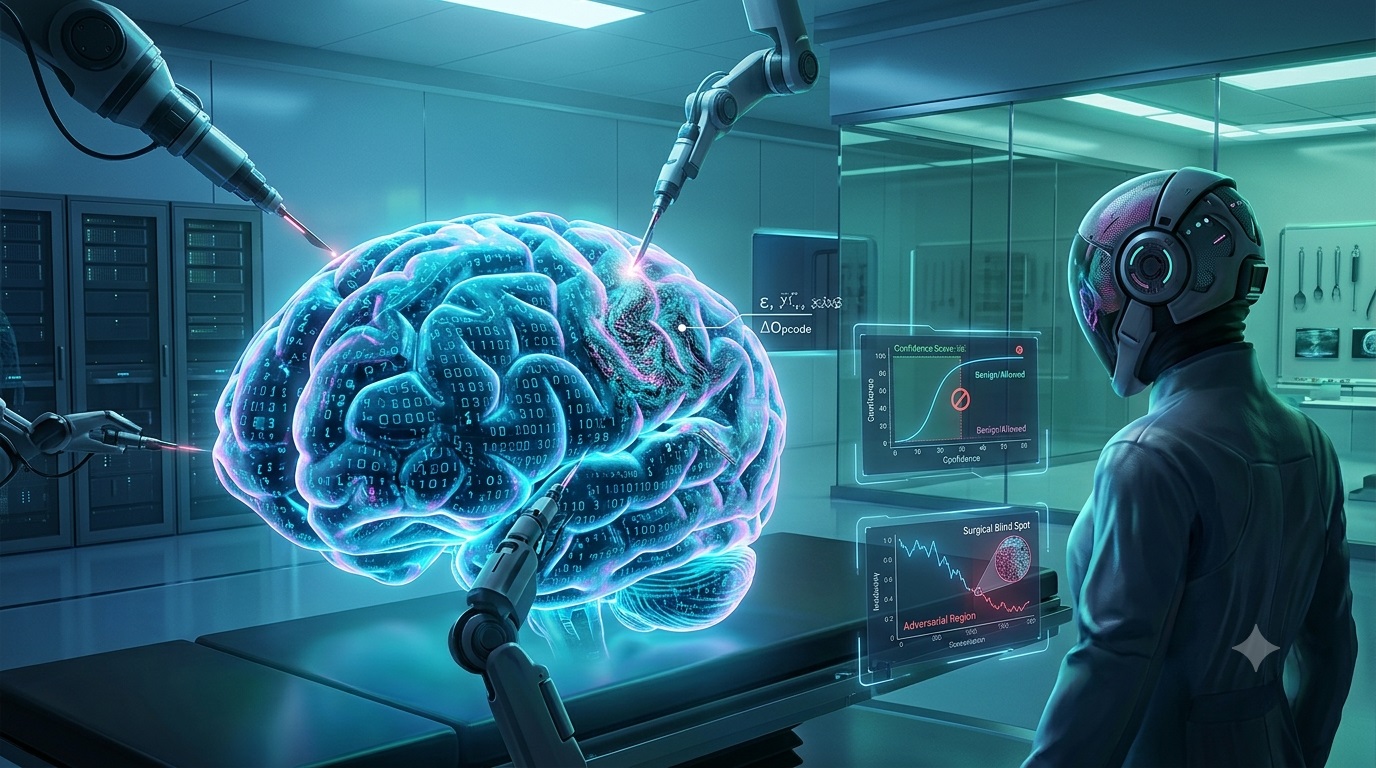
#《隱形兵器 II:盲區手術》| Adversarial Machine Learning, Model Poisoning & Defensive Blind Spots | IDRI
《隱形兵器》
紅隊三部曲・中篇:盲區手術
——如果你無法遮住對方的眼睛,那就改變它所相信的世界
01|0.018
凌晨 03:07。
紅隊基地。
林祈安仍然坐在那張桌子前。
螢幕上的數字沒有變。
0.018
她已經看了三個小時。
程遠走進來。
「還沒睡?」
「沒有。」
「那個數字?」
「嗯。」
程遠把咖啡放在她旁邊。
「不就是 uncertainty?」
「不是。」
「那是什麼?」
林祈安沒有回答。
她把第一篇所有實驗重新跑了一遍。
不同 seed。
不同時間窗。
不同 sampling。
不同 baseline。
結果始終存在一個極小、但穩定的偏差。
P(unknown) ≈ 0.018
不是 noise。
不是 random artifact。
更不是模型偶然發瘋。
它像一根極細的針。
一直扎在模型的 latent space 裡。
林祈安終於說:
「我們的模型不知道自己不知道什麼。」
程遠皺眉。
「這不是很正常?」
「正常。」
她停了一下。
「但如果藍隊知道這件事呢?」
02|Aster
另一座城市。
顧青禾正在看同一個數字。
但她看到的不是:
0.018
而是一條曲線。
過去十七天。
未知行為的比例沒有增加。
甚至略微下降。
但 uncertainty 的分布開始產生結構。
不是:
Random Noise
而是:
Structured Uncertainty
顧青禾靠在椅背上。
「它開始知道我們在看。」
分析師問:
「你確定?」
「不。」
「那為什麼這樣判斷?」
她回答:
「因為真正隨機的東西,不會在我們改變觀測策略之後,跟著改變自己的形狀。」
她打開另一個視窗。
Model drift。
Data provenance。
Feature attribution。
全部正常。
只有一個東西不正常。
模型開始學會防禦模型。
03|第二層戰場
Richard在白板上寫下:
Network
   ↓
Behavior
   ↓
Model
然後把最後一個圈起來。
「第一篇。」
他說。
「我們在跟網路行為玩。」
「現在呢?」
程遠問。
Richard回答:
「我們開始跟相信網路行為的東西玩。」
周野抬頭。
「AI。」
「對。」
林祈安沒有說話。
她知道Richard真正想說的是:
Detection Model 本身就是 attack surface。
04|XDR
藍隊的新系統代號:
ASTER-X
不是單一模型。
是一個多模型協作框架。
Endpoint Telemetry
        ↓
Feature Extraction
        ↓
Behavior Encoder
        ↓
┌─────────────────────┐
│                     │
│  Network Model      │
│  Process Model      │
│  Identity Model     │
│  Graph Model        │
│  Temporal Model     │
│                     │
└──────────┬──────────┘
           ↓
     Risk Aggregator
           ↓
     Analyst Context
它最大的改變不是模型更深。
而是:
模型開始互相驗證。
一個模型說:
「可疑。」
另一個模型會問:
「證據?」
第三個模型再問:
「這個 evidence 是否與 historical behavior 一致?」
顧青禾把這套架構看了很久。
她知道:
這東西比第一代 XDR 強很多。
但她也知道。
越複雜的系統,越容易形成新的盲區。
05|Quill 的問題
林祈安在白板上寫:
Where does the model look?
下面又寫:
Where does the model refuse to look?
Richard看著她。
「妳想做什麼?」
「找 decision boundary。」
「太直接。」
「所以我要從 uncertainty 開始。」
周野問:
「妳想知道模型在哪裡不確定?」
「不。」
林祈安說:
「我想知道它在哪裡自信地錯。」
房間安靜了。
Richard笑了一下。
「這就開始有意思了。」
06|錯誤的形狀
任何分類模型都有錯誤。
問題不在於:
模型會不會錯。
而在於:
錯誤是不是有結構。
林祈安把模型輸出的 embedding 降維。
螢幕上出現一大片點。
正常行為形成幾個 cluster。
已知威脅形成另一側。
未知行為散落在邊界。
但其中有一小群。
非常奇怪。
它們不在正常區域。
也不在威脅區域。
而是在兩者之間。
林祈安放大。
「這裡。」
程遠問:
「什麼?」
「Decision boundary。」
Richard看著那片區域。
「所以?」
她回答:
「這裡不是漏洞。」
「這是什麼?」
「是模型對世界的理解方式。」
07|顧青禾的答案
藍隊也看到了那個區域。
但顧青禾沒有直接調整 threshold。
她先做了一件很少人願意做的事情:
承認模型不知道。
她把那一區標記:
Human Review Required
分析師問:
「這樣不是增加 workload?」
「會。」
「很多?」
「很多。」
「那為什麼?」
顧青禾看著他。
「因為我們如果只接受模型舒服的答案。」
「最後就會得到一個非常漂亮的錯誤世界。」
她把 threshold 暫時放低。
False Positive 上升。
SOC 開始抱怨。
但顧青禾沒有改。
她知道。
安全不是讓模型永遠正確。
而是讓錯誤發生時,有人知道它可能錯了。
08|Red Team 的第二階段
紅隊開始做 model-oriented evaluation。
不是修改 payload。
不是改變 exploit。
甚至沒有碰藍隊系統。
他們建立一個 shadow environment。
用來觀察:
模型如何做決策。
輸入。
輸出。
再輸入。
再輸出。
林祈安把每次結果記錄下來。
她觀察:
- feature sensitivity
- confidence calibration
- decision stability
- representation drift
- attribution consistency
她沒有追求:
「怎麼讓惡意樣本被判成正常。」
那太低階。
她真正想知道的是:
模型在哪些情境下會改變自己的判斷?
09|FGSM
程遠看到 notebook 裡的一行字。
FGSM
他問:
「要真的做?」
林祈安搖頭。
「研究環境。」
「我知道。」
她補充:
「我們不碰 production。」
她在白板寫下概念:
x' = x + ε · sign(∇_x J(θ, x, y))
周野看了一眼。
「很漂亮。」
「數學很漂亮。」
「實際呢?」
林祈安說:
「實際世界沒那麼乾淨。」
因為真實系統不是一個簡單 image classifier。
Endpoint telemetry 有:
- 離散特徵
- 時間特徵
- categorical feature
- process relationship
- graph topology
- system constraints
所以紙上的 gradient:
不能直接等價於真實世界的可操作變化。
Richard點頭。
「很好。」
程遠問:
「哪裡好?」
「她開始討厭漂亮公式了。」
10|模型的錯覺
林祈安做了一組實驗。
她沒有尋找某個特定 payload。
而是觀察模型對微小 feature perturbation 的敏感度。
結果令人不舒服。
某些 feature 改變非常小。
模型 confidence 卻出現明顯變化。
Δx → small
但:
Δconfidence → large
林祈安盯著結果。
「這不是 robust model。」
Richard問:
「那是什麼?」
「一個很會回答問題。」
她停了一下。
「但不一定知道答案的模型。」
11|Poison
第二階段真正開始。
不是:
Attack the Model。
而是:
Attack What the Model Learns From。
顧青禾收到一份新的 data provenance report。
某些歷史資料出現微小異常。
來源沒有斷。
格式沒有壞。
timestamp 沒有明顯問題。
甚至 checksum 都正常。
但 metadata lineage:
不完整。
她皺眉。
「誰碰過 training corpus?」
沒有人回答。
她再次問:
「我要完整 provenance。」
資料工程師說:
「目前只能追到 ingestion layer。」
顧青禾看著他。
「再往前。」
「可能需要時間。」
她回答:
「時間就是現在最貴的東西。」
12|Richard的警告
紅隊內部。
程遠提出:
「如果能污染資料,模型就會自己替我們放大錯誤。」
周野冷冷地說:
「所以你開始覺得很興奮?」
「不是。」
「你臉上就是。」
Richard打斷兩人。
「Data poisoning 最麻煩的地方。」
所有人看向他。
「不是把資料改掉。」
「而是讓別人不知道資料被改過。」
他在白板上寫:
Data
  ↓
Training
  ↓
Model
  ↓
Decision
然後在 Data 與 Training 中間畫了一條線。
「真正的攻擊面,是 trust boundary。」
13|顧青禾開始逆向
顧青禾沒有直接追攻擊者。
她追資料。
她要求所有 training data 重新建立 lineage graph。
結果出現:
Source
 ↓
Collector
 ↓
Normalizer
 ↓
Feature Pipeline
 ↓
Dataset
 ↓
Training Job
 ↓
Model
其中有一條路徑:
沒有完整 provenance。
只有一個名字。
legacy-ingest
顧青禾盯著那個名稱。
她問:
「誰寫的?」
工程師說:
「很久以前的 pipeline。」
「多久?」
「三年左右。」
她沒有再問。
只說:
「先隔離。」
遠方。
周野正在看同一個名字。
14|Legacy
他盯著 terminal。
legacy-ingest
又看了一眼Richard。
「這名字。」
Richard說:
「我看過。」
「在哪?」
「以前。」
周野皺眉。
「你知道?」
「知道。」
「為什麼不說?」
Richard沉默了兩秒。
「因為我希望它已經不存在。」
這是第一次。
林祈安看到Richard真正的不安。
15|三年前
畫面切換。
三年前。
同一家公司。
另一批工程師。
另一間機房。
凌晨 02:43。
一個年輕工程師盯著 pipeline。
Build fail。
Retry。
再 fail。
他已經連續工作十六個小時。
同事問:
「還不走?」
「再五分鐘。」
他打開一段舊程式。
看到:
TODO
又看到:
temporary workaround
他嘆了一口氣。
「明天再改。」
他沒有想到:
三年後,這五分鐘會成為別人的問題。
16|回到現在
周野把視窗關掉。
「所以你早就知道?」
Richard回答:
「我知道那套系統。」
「知道它有問題?」
「知道它可能有問題。」
周野看著他。
「差很多。」
Richard點頭。
「對。」
林祈安問:
「為什麼沒有修?」
Richard沒有立即回答。
最後只說:
「因為當時還有更重要的事情。」
林祈安第一次沒有反駁。
因為她突然明白:
這才是真實世界。
不是:
Bug → Fix
而是:
Bug → Priority → Deadline → Risk Acceptance
17|模型開始偏移
藍隊的模型重新訓練。
結果變好。
Validation metrics 幾乎全部改善。
顧青禾卻皺眉。
「太好了。」
工程師說:
「不是好事嗎?」
「好得不自然。」
她看著 calibration curve。
某些區域的 confidence 提升得太漂亮。
她問:
「我們的 validation set 有沒有完全獨立?」
「有。」
「真的?」
「是。」
「Temporal split?」
「有。」
「Source split?」
「……沒有。」
顧青禾閉上眼睛。
「重新做。」
18|資料不是記憶
林祈安也得到了同樣的答案。
她對Richard說:
「Model 可以忘記。」
Richard看她。
「什麼?」
「如果 training data 被污染。」
「模型可能把錯誤當成記憶。」
Richard說:
「模型沒有記憶。」
林祈安搖頭。
「所以才危險。」
她看著螢幕。
「它不記得事情。」
「它只記得事情留下來的統計痕跡。」
這句話讓周野安靜了很久。
19|Blind Spot
紅隊重新分析藍隊模型。
這次不是找:
怎麼騙過模型。
而是:
模型最不可靠的地方在哪裡。
結果出現三種區域:
High Confidence / Correct
High Confidence / Wrong
Low Confidence / Unknown
真正危險的是第二個。
High Confidence + Wrong
Richard看著它。
「這就是盲區。」
林祈安點頭。
「不是模型看不到。」
「而是它看到了。」
「然後非常有自信地解釋錯。」
20|Aster 的反擊
顧青禾開始改變策略。
不再只看:
Confidence
她加入:
Uncertainty
Provenance
Cross-Model Agreement
Temporal Stability
最後形成新的 decision layer:
Model Confidence
       +
Uncertainty
       +
Data Provenance
       +
Cross-Model Agreement
       +
Temporal Consistency
       ↓
Human Review
林祈安看到這套架構時,沉默了很久。
「她在做什麼?」
Richard回答:
「她正在把模型的自信拆掉。」
21|真正的手術
這次紅隊沒有進一步追求更好的 deception。
Richard下了一個命令:
停止優化。
程遠愣住。
「什麼?」
「停止。」
「為什麼?」
Richard看著他。
「因為我們已經知道模型會錯。」
「接下來要做的是。」
他看向林祈安。
「找出它為什麼相信自己錯得對。」
這一刻。
紅隊的目標改變。
從:
Evade Detection
變成:
Understand Detection
而這才是真正的:
Blind Spot Surgery。
22|兩個世界
藍隊。
顧青禾正在修正自己的模型。
紅隊。
林祈安正在研究它。
兩邊都在做同一件事情:
尋找 uncertainty。
不同的是:
藍隊想消除它。
紅隊想利用它。
Richard卻知道。
這兩個答案都不完整。
他走到窗前。
夜色很深。
他忽然想起多年前的自己。
也是這樣。
以為只要把所有變數控制住。
事情就不會失控。
後來才知道:
真正讓系統失控的,往往不是變數。
而是:
人以為自己已經理解了變數。
23|最後一個樣本
凌晨 05:18。
林祈安跑最後一輪測試。
螢幕出現:
Confidence: 0.997
她沒有笑。
下面:
Provenance Confidence: 0.61
再下面:
Cross-Model Agreement: 0.48
最後:
Human Review: REQUIRED
她盯著那四行。
第一篇那個 0.018 又浮現在她腦中。
這一次。
她終於理解:
不確定性不是弱點。
它是系統誠實面對世界的最後一塊地方。
24|顧青禾的選擇
藍隊可以選擇直接提高 threshold。
也可以選擇降低 false positive。
甚至可以把所有 anomaly 強行分類。
但顧青禾沒有。
她按下:
RETAIN UNKNOWN
螢幕顯示:
Unknown states will remain unresolved.
工程師問:
「這樣不會很麻煩?」
她回答:
「會。」
「那為什麼?」
顧青禾看著他。
「因為安全系統最可怕的錯誤,不是說不知道。」
「是把不知道寫成知道。」
25|最後的裂痕
紅隊基地。
林祈安關掉 notebook。
程遠問:
「我們成功了嗎?」
她搖頭。
「沒有。」
「那我們失敗?」
「也沒有。」
程遠開始不耐煩。
「到底是什麼?」
林祈安看向Richard。
Richard沒有回答。
她說:
「我們只是證明了一件事。」
「什麼?」
「模型可以被影響。」
她停了一下。
「但模型也可以知道自己被影響。」
Richard看著她。
第一次沒有糾正。
26|The Blind Spot
顧青禾收到最後一份報告。
其中有一行:
Legacy ingestion path isolated.
她準備關掉畫面。
忽然。
另一個 alert 出現。
不是 malware。
不是 anomaly。
不是 C2。
只有:
Model disagreement detected.
她看了三秒。
然後笑了。
很輕。
「終於。」
同一時間。
紅隊模型也收到一個新的 signal。
Defensive Adaptation Detected.
林祈安看著螢幕。
「她開始改了。」
Richard說:
「嗯。」
「現在呢?」
Richard站起來。
拿起外套。
「現在,才算真正開始。」
《盲區手術》・完
Story Background|本篇故事背景
第一篇的戰場是:
Behavior。
第二篇則正式進入:
Model。
紅隊發現,藍隊的 AI 威脅偵測系統本身存在 representation、confidence、uncertainty 與 data provenance 等問題。
但藍隊並沒有停留在傳統的:
「提高模型準確率。」
而是開始意識到:
模型的錯誤本身就是攻擊面。
因此雙方的戰場從:
Network
   ↓
Traffic
   ↓
Behavior
進一步變成:
Behavior
   ↓
Representation
   ↓
Model
   ↓
Training Data
   ↓
Decision
Technical Architecture|本篇技術架構
紅隊
Behavior Dataset
       ↓
Representation Analysis
       ↓
Model Evaluation
       ↓
Decision Boundary Analysis
       ↓
Robustness Testing
       ↓
Blind-Spot Discovery
藍隊
Telemetry
    ↓
Feature Pipeline
    ↓
Multiple Models
    ↓
Confidence
    +
Uncertainty
    +
Provenance
    +
Cross-Model Agreement
    ↓
Human Review
本篇特別重要的概念:
- Adversarial Machine Learning
- FGSM / gradient-based robustness evaluation
- Decision Boundary
- Confidence Calibration
- Model Uncertainty
- Distribution Shift
- Data Provenance
- Data Lineage
- Training-Serving Skew
- Cross-Model Agreement
- Model Drift
- Representation Space
- High-Confidence Error
- Human-in-the-Loop
這裡刻意沒有把攻擊寫成「輸入一段神奇字串 → 模型立刻變瞎」。
那種寫法很爽。
也很假。
真正困難的地方是:
模型是一個複雜系統。
攻擊者要找的通常不是某個神奇 input。
而是:
哪些條件組合會讓模型產生穩定、可重現、而且人類不容易察覺的錯誤?
Character Development|人物變化
林祈安
第一篇:
「模型只要夠好,就能描述世界。」
第二篇:
「模型會犯錯。」
到了本篇結尾,她第一次理解:
「模型知道自己可能錯」比「模型永遠正確」更重要。
這會直接影響第三篇。
Richard
他開始看到一件自己不喜歡的事情:
自動化攻防正在逐漸脫離人的直覺。
他開始從「如何攻擊」轉向「何時停止」。
這會成為第三篇最大的道德衝突。
周野
他第一次碰到一個自己不熟悉的問題:
漏洞不一定存在於 code。
它可能存在於:
Dataset
Pipeline
Assumption
甚至:
Priority
他仍然相信 machine state。
但開始理解:
machine state 是人類決策累積出來的結果。
顧青禾
她從第一篇的:
找異常
進化到:
管理未知。
她沒有試圖消滅 uncertainty。
而是選擇保留它。
這個決定在第三篇會付出代價。
Hidden Foreshadowing|下一篇伏筆
① `legacy-ingest`
三年前的舊 pipeline 已經正式登場。
但它還不是答案。
它只是入口。
② 「Temporary workaround」
三年前那個工程師留下的東西,會再次出現。
而第三篇才會揭露:
真正危險的漏洞,往往不是沒人知道。
而是:
所有人都知道,但沒有人覺得今天需要處理。
③ `Model disagreement`
這不是普通 alert。
它代表:
藍隊的防禦系統開始產生內部認知分裂。
而紅隊也開始擁有足夠的自動化能力,去理解這種分裂。
④ Human Review
顧青禾選擇保留人工判斷。
這看似成熟。
但第三篇會提出一個殘酷問題:
當攻防速度進入機器時間尺度時,人類還來得及 review 嗎?
Leo's Note|技術後記
第一篇寫的是:
「如何看起來正常。」
第二篇寫的是:
「誰決定什麼叫正常。」
這兩個問題看起來只差幾個字。
實際上差了一整個世界。
很多 AI Security 報告喜歡寫:
Accuracy 99.7%
看起來很漂亮。
漂亮到像新車交車。
但真正做過系統的人知道,真正應該問的是:
那剩下的 0.3% 是什麼?
更討厭的是:
它是不是剛好發生在最重要的地方?
一個模型可以有極高 accuracy。
同時在某個極窄的 decision region 裡,非常有自信地錯。
這不是 bug。
這就是 machine learning。
模型不是世界。
模型只是:
對世界的一種壓縮。
而所有壓縮都有遺失。
四十五歲之後,我反而越來越不相信「完美系統」。
不是悲觀。
是看過太多 production。
真正成熟的工程師,不會跟你說:
「這套系統不會出問題。」
他會告訴你:
「這套系統出了問題,我知道它大概會從哪裡壞。」
這兩句話的價值,差得非常遠。
所以顧青禾選擇保留:
Unknown
而不是假裝世界已經被模型解完。
這是她目前最大的優勢。
也是她下一篇最大的弱點。
因為到了第三篇。
當兩邊的模型開始自動化迭代。
當 fuzzing、symbolic execution、reinforcement learning 與 automated response 開始進入 machine-speed。
「等人類來判斷」本身,可能就變成最大的 latency。
而那個三年前被寫成:
temporary workaround
的東西。
還在。
安靜地躺在某個不起眼的 memory lifecycle 裡。
沒有人每天看它。
沒有人覺得它重要。
直到有一天。
兩台機器都開始尋找漏洞。
卻只有一個老工程師曾經知道:
為什麼那段 code 當初會寫成那樣。
下一篇。
**《代碼的宿命》**
到那裡,這場戰爭才真正開始從「攻防」變成「速度」。
而速度一旦快過人類。
問題就不再是:
誰比較聰明。
而是:
誰留下的那個小錯誤,還活著。